Comprendre une URL comme un(e) dev
Salut !
Si tu codes depuis peu, ou si tu as déjà cliqué sur un lien ou tapé une adresse dans ton navigateur, tu as utilisé une URL. Tu sais, ce truc qu’on copie-colle 50 fois par jour sans trop y penser ? 😅
Eh bien aujourd’hui, on va parler d’URL, et je vais te décortiquer ça à la sauce dev : clair, imagé, et sans prise de tête. 😁
C’est quoi une URL ?
Une URL (Uniform Resource Locator), c’est l’adresse complète d’une ressource sur Internet.
Un peu comme le chemin vers un fichier… sauf qu’au lieu de pointer vers ton disque dur, ça vise des trucs sur des serveurs.
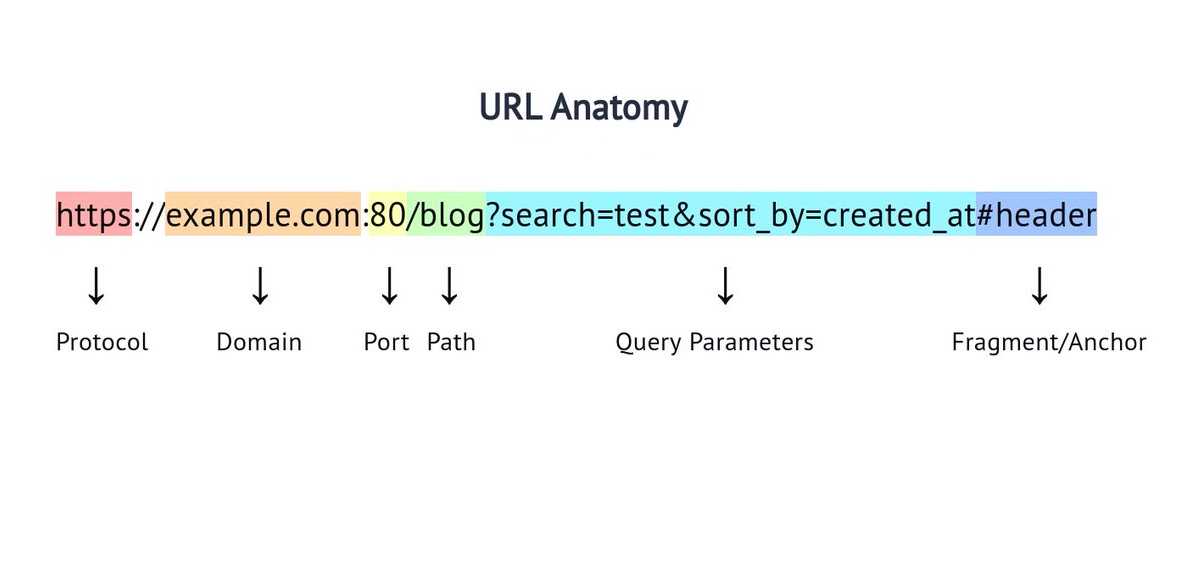
Structure d’une URL
Prenons cet exemple :
https://example.com:80/blog?search=test&sort_by=created_at#header
1. https:// — Le protocole
C’est la première partie de l’URL. Elle indique comment ton navigateur va communiquer avec le serveur.
Un peu comme choisir entre téléphoner 📞 ou envoyer un SMS 💬.
Quelques exemples :
http: HyperText Transfer Protocol (le plus classique)https: version sécurisée avec chiffrement TLS 🔒
Depuis les années 2010, Google pousse au HTTPS : les sites non sécurisés sont moins bien référencés.
En bref : c’est le langage utilisé pour envoyer une requête et recevoir une réponse.
Un genre de fetch() universel.
2. example.com — Le domaine
C’est le nom du serveur qui héberge la ressource.
Comparable à un numéro de rue, mais version Internet.
Ce nom est traduit en adresse IP grâce au DNS (Domain Name System), le bottin du web.
Structure typique :
Sous-domaine :
www,blog,apiDomaine principal :
example,openai,googleExtension (TLD) :
.com,.fr,.io,.dev
const domaine = {
  sousDomaine: "www",
  nom: "example",
  extension: ".com"
};
3. :80 — Le port
Le port, c’est la porte d’entrée de la requête vers le serveur.
80: par défaut pourhttp443: pourhttps
Souvent invisible, car les navigateurs les ajoutent automatiquement selon le protocole.
Mais si tu codes en Node.js ou Express, tu connais sûrement :
app.listen(3000);
4. /blog — Le chemin
Le chemin, c’est la route vers la ressource sur le serveur.
Comme les dossiers dans ton projet, mais côté serveur.
Plus il y a de
/, plus tu descends dans l’arborescence.
Dans les frameworks modernes (Vue, React, Angular…), ce chemin est souvent géré par le router côté client.
5. ?search=test&sort_by=created_at — Les paramètres de requête
Après le ?, on trouve les informations envoyées au serveur via la méthode GET.
Structure : clé=valeur
Chaque paire est séparée par &.
Exemple :?q=vuejs&page=2
En backend :
Express.js :
req.queryPHP :
$request->query()
6. #header — Le fragment (ou ancre)
Le fragment, c’est le petit # qui te téléporte dans la page.
Tu connais sûrement :
<a href="#section-3">Aller à la section 3</a>
Ça dit au navigateur : “scroll direct là-bas”.
URL absolue vs relative
Les URL, ce sont des chemins. Et il y a deux types :
URL absolue
Elle contient tout : protocole, domaine, chemin complet.
https://site.com/blog/article
URL relative
Elle dépend du contexte actuel (la page en cours, le niveau du dossier, etc.).
/blog/article           // relatif à la racine
../images/pic.jpg       // monte d’un dossier
En résumé
Lire une URL → comprendre ce que fait ton navigateur
Écrire une URL propre → améliorer la navigation, le SEO, l’accessibilité
Maîtriser les URL, c’est poser la première pierre d’un web solide.
Si tu as aimé ce genre de décryptage, n’hésite pas à me le dire ou à poser tes questions en commentaire ! 🚀
About the author
Software Developer et Web Designer. Je conçois et développe des applications web modernes.
Transformer une idée en produit digital fonctionnel est ma motivation. Au fil des années, j’ai réalisé de nombreux projets illustrant mon parcours, de l’inspiration à l’exécution, toujours guidés par l’expérience utilisateur.
Comments
Join the discussionNo comments yet. Be the first to comment.